数据服务与数据处理服务 概念、差异与协同价值
在数字化转型浪潮中,"数据服务"与"数据处理服务"是高频出现却又常被混淆的两个概念。许多企业在规划数据能力时,往往将二者等同视之,导致资源错配或期望偏差。事实上,它们分别指向数据价值链的不同环节,既有明确分工,又存在深度协同。厘清二者的内涵、边界与关系,是构建高效数据体系的前提。
一、数据服务:以“用”为核心的交付形态
数据服务(Data Service)强调将数据以标准化、可复用的方式提供给消费方,其本质是"数据用起来"的最后一公里。典型形态包括:数据API、数据报表、数据视窗、标签查询服务,以及面向业务系统的实时数据接口。数据服务的核心特征在于"契约化"——服务提供方与消费方之间通过接口协议、服务等级协议(SLA)和元数据描述形成明确约定,使数据能够像水电一样按需取用。
在技术架构上,数据服务通常依托API网关、数据虚拟化层或微服务框架,将底层物理表的查询逻辑封装为面向业务语义的服务端点。度量数据服务的关键指标包括接口响应时延、调用成功率、服务复用度和消费方满意度。值得强调的是,数据服务的价值不在于数据本身多大,而在于是否精准嵌入业务流程——只有被业务系统高频调用、直接驱动决策或操作的数据服务,才具备真正的生命力。
二、数据处理服务:以“治”为基础的能力体系
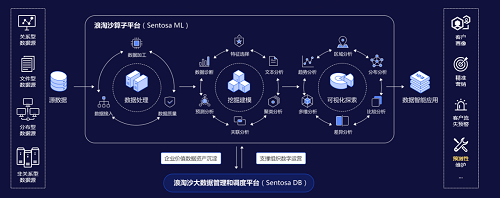
数据处理服务(Data Processing Service)聚焦于数据从原始形态到可用形态的转化过程,涵盖采集、清洗、转换、融合、聚合、存储与计算等环节。其交付方式可以是全托管的平台服务(如云上数据加工流水线),也可以是定制化的工程实施服务(如数据仓库建设、实时数仓搭建),还可以是持续运营型服务(如数据质量监控、血缘治理)。
数据处理服务的核心诉求是"可用性"与"可信性":原始数据往往存在缺失、重复、格式不一致、时效滞后等问题,必须经过系统化加工才能支撑分析或服务。其关键度量指标包括数据完整性、一致性、及时性和准确性,以及加工任务的时效与资源成本。从技术栈看,批处理、流计算、数据集成、数据质量规则引擎等均属其范畴。形象地说,数据处理服务是为数据"修路架桥"的基础工程,没有这一层,数据服务便成了无源之水。
三、核心差异:供给逻辑与价值定位
从价值定位看,数据处理服务是"向内做功",解决数据"有没有、对不对、来得快不快"的问题;数据服务则是"向外交付",解决数据"怎么用、给谁用、好不好用"的问题。从交付对象看,前者主要面向数据工程师与分析师,后者主要面向业务系统与一线人员。从时间维度看,数据处理服务可呈周期性批量作业形态,数据服务则要求恒定的在线可用性。从度量视角看,前者看重质量与成本,后者看重体验与复用。
一个常见误区是以处理服务的完备程度替代服务化能力——建设了庞大的数仓与治理体系,却缺乏面向场景的接口封装,导致数据"存而难用";反之,跳过治理直接暴露原始查询,则会造成口径混乱与性能风险。二者不可互相替代。
四、协同闭环:从“治”到“用”再反哺“治”
真正成熟的数据体系,是处理服务与服务化双轮驱动形成的闭环。数据服务在实践中会暴露口径不一致、响应过慢、字段缺失等问题,这些反馈反哺数据处理侧优化模型与质量规则;数据处理侧新增的指标与主题域,又通过服务化快速触达前端,验证价值、缩短变现周期。某零售企业的实践颇具代表性:先将订单、库存等多源数据经处理服务统一为一致性维度模型,再以API化数据服务嵌入门店补货与营销系统,前端调用中出现的高时延字段与不合理颗粒度直接驱动了后端模型的迭代优化——这便是“以用促治、以治保用”的良性循环。
五、实践建议
企业推进数据能力建设时,宜摒弃"先建大平台再谈服务"或"唯接口论"的极端思路。建议以场景为牵引:先识别3—5个高价值业务场景所需的指标口径,倒推处理侧需保障的数据范围与质量级别,再按场景封装最小可用的数据服务并持续度量调用效果。建立统一的元数据与服务目录,将每一项数据服务的底层处理链路与质量责任明确标注,实现可追溯、可治理的供应链式管理。唯有处理服务做扎实,数据服务才站得稳;唯有需求端反馈高效回流,处理服务才不致沦为低效的库存积压。
如若转载,请注明出处:http://www.baiying101.com/product/110.html
更新时间:2026-11-21 07:52:39